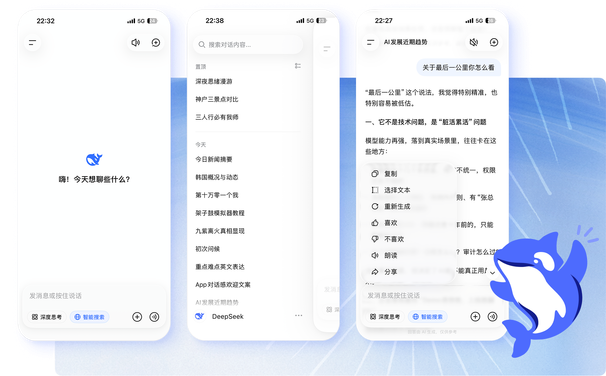
🎉 DeepSeek R1深度思考模型 已发布并开源,性能对标主流推理模型,在 DeepSeek网页版入口 与 DeepSeek api开放平台 全面上线。
DeepSeek | 推理更稳 - 官方人工智能
DeepSeek - 探索未至之境 · 依托原生强化学习思维链(Chain-of-Thought)与 671B 混合专家架构,为科研推导与企业研发提供稳健可靠的人工智能智核。
DeepSeek-V3 与 Deep Seek 全栈架构的综合能力
Deep Seek(深度求索,DeepSeek官网)研发的旗舰模型采用多头潜在注意力(MLA,即通过低秩键值联合压缩削减 75% 推理显存占用)与混合专家路由(MoE,总参数 671B、每 Token 仅激活 37B 参数),在推理速度与数学代码精度上实现跨越。
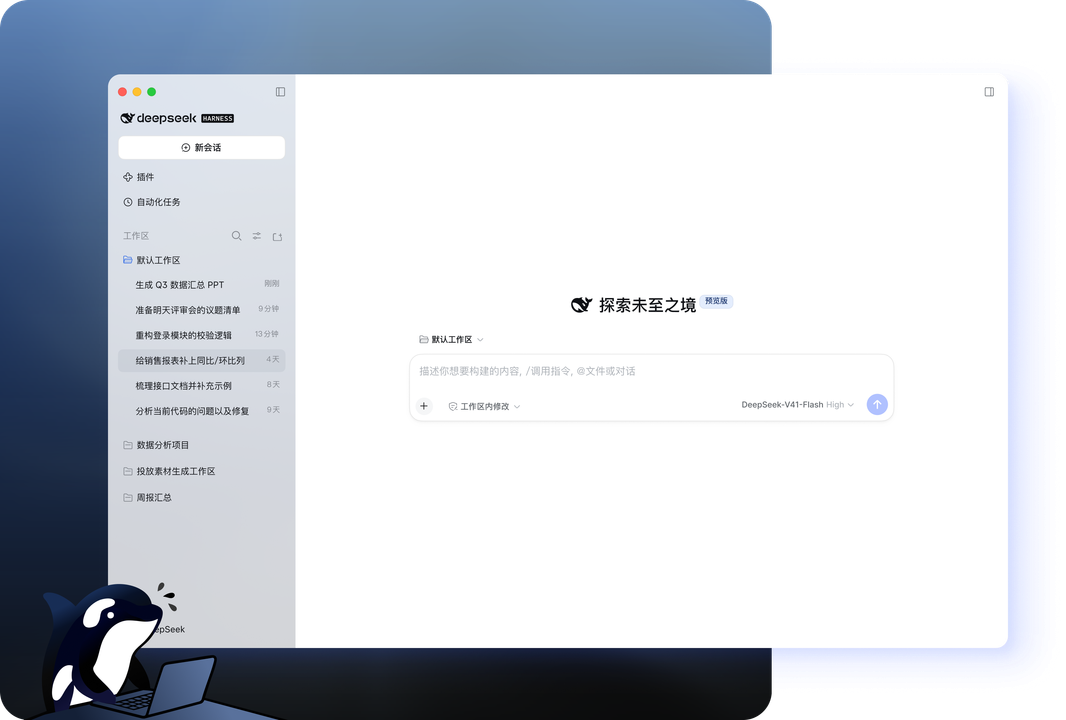
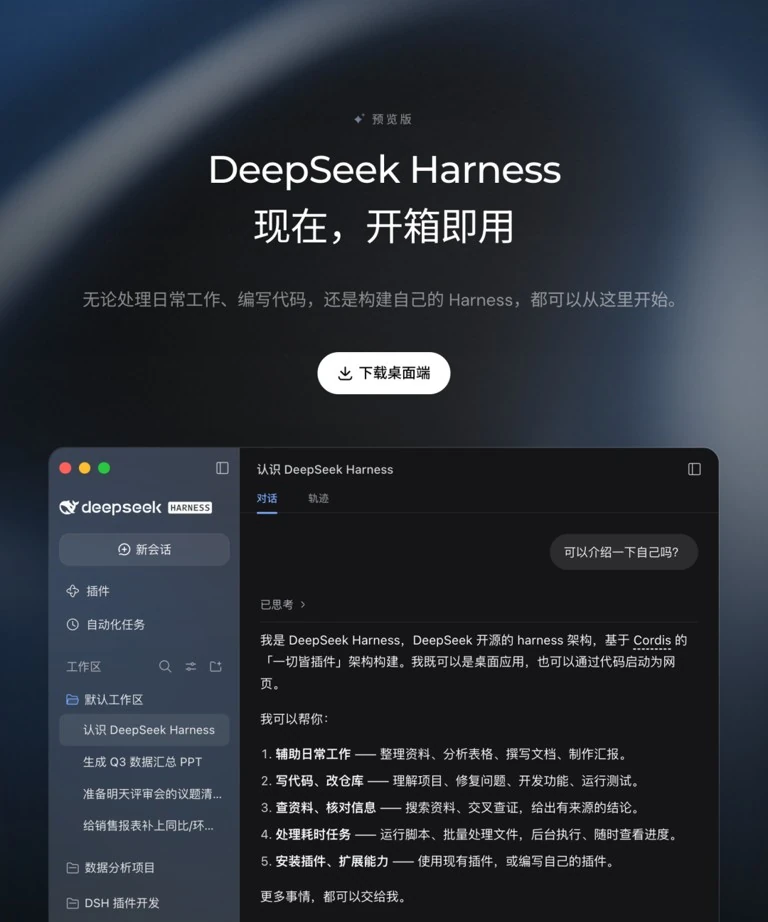
通过 DeepSeek api开放平台(支持分布式硬盘前缀缓存自动命中的标准接口网关)与 DeepSeek Harness(固定随机种子 seed=42 的零样本评测流水线),开发者可在线开启 DeepSeek网页版在线对话 或复现 MATH-500 达 92.8% 的开源榜单成绩。